
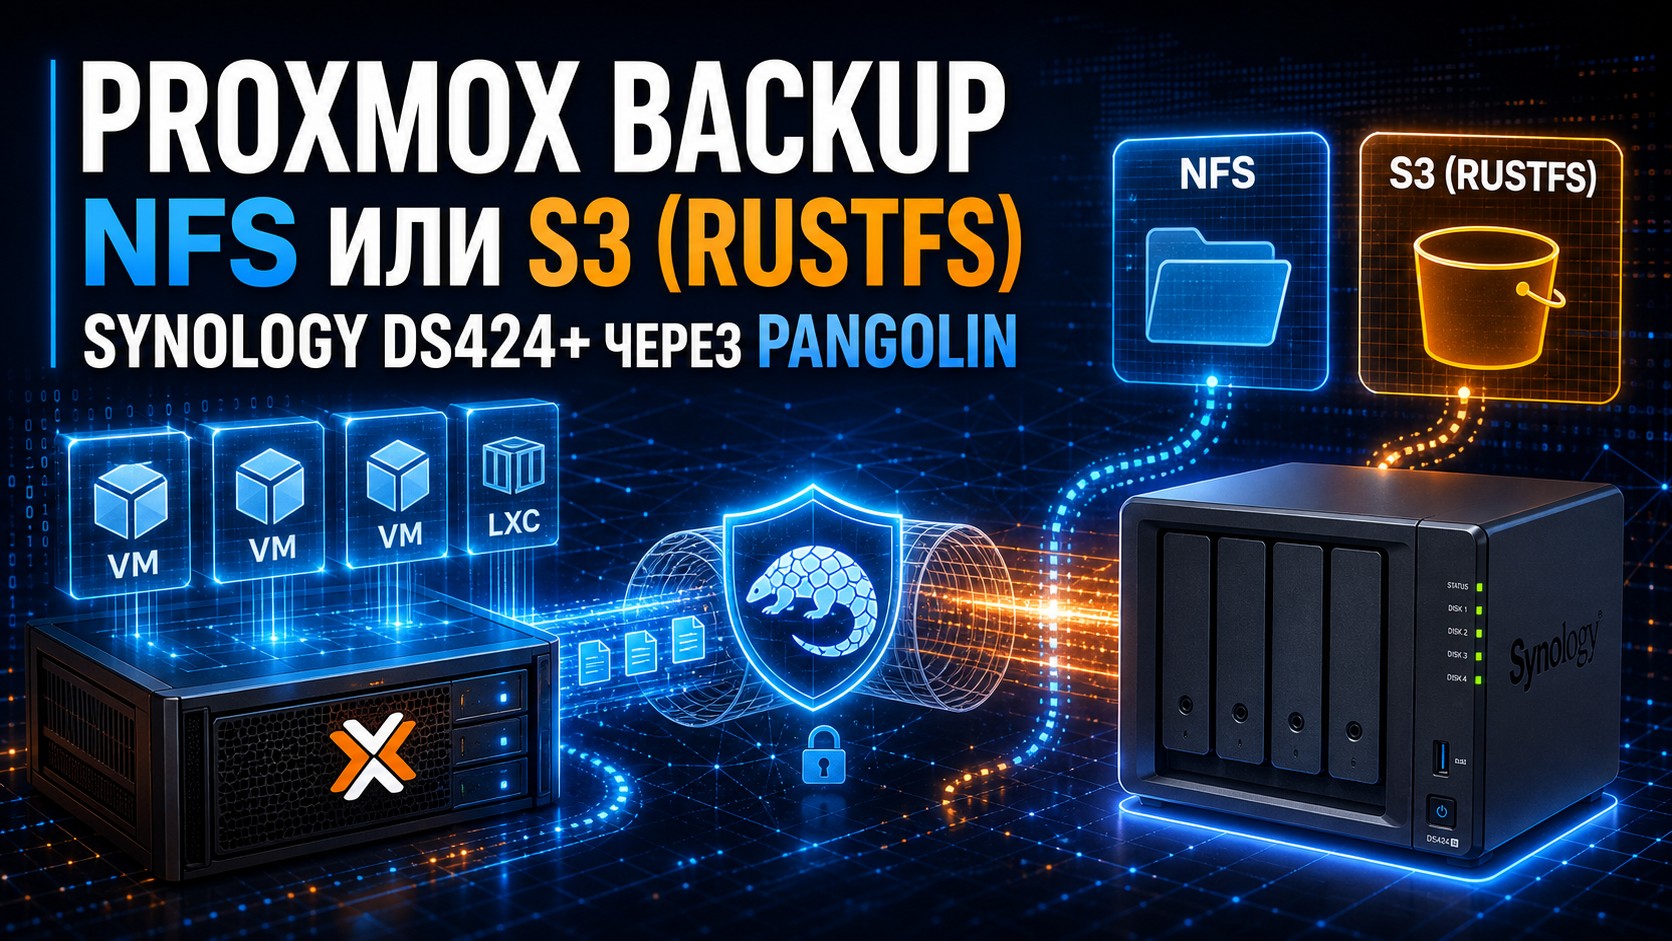
Привет! До недавнего времени для хранения резервных копий контейнеров и виртуальных машин из своей Proxmox-лабы я использовал NFS. Сама NFS-шара находилась на Synology NAS, доступ к которому был организован через сайт в Pangolin.
В целом такая схема работала без проблем, но по мере увеличения количества контейнеров время выполнения резервного копирования стало заметно расти. При этом создание снимка и синхронизация выполнялись достаточно быстро, а основным узким местом оказалась запись готового архива в NFS. Со временем этот этап начал едва укладываться в отведённое для бэкапа окно, хотя общий объём данных практически не изменился.
Тогда появилась идея: а что, если отказаться от NFS и попробовать S3-совместимое хранилище? Тем более что на том же NAS у меня уже был развёрнут RustFS — оставалось только подключить его и проверить на практике.
Ниже расскажу, как я это настроил, с какими нюансами столкнулся и что в итоге получилось.
Архитектура решения

Здесь сразу стоит оговориться: сам Proxmox VE не поддерживает S3 в качестве типа хранилища. В отличие от него, в отдельном продукте Proxmox Backup Server поддержка S3 уже появилась, хотя на данный момент она всё ещё находится в статусе Technology Preview. Поэтому S3-бакет придётся подключать обходным путём: смонтировать его через FUSE и добавить в Proxmox как обычное dir-хранилище. Для самого Proxmox такое хранилище будет выглядеть как обычная директория на диске.
Есть ещё один нюанс, связанный с работой vzdump, в котором поначалу легко запутаться. Резервное копирование проходит в два основных этапа. Сначала vzdump с помощью rsync копирует живую файловую систему контейнера во временную директорию на локальном диске:
/var/lib/vz/tmp/vzdumptmp<pid>_<vmid>/
Это необходимо для получения консистентного состояния файловой системы перед созданием архива.
Дальше всё происходит немного интереснее. Готовый архив не создаётся сначала во втором временном файле с последующим копированием на целевое хранилище. Вместо этого tar читает данные непосредственно из временной директории и через pipe передаёт их в zstd. Уже сжатый поток сразу записывается в конечный путь на смонтированном через FUSE хранилище — в данном случае в кэш rclone.
Таким образом, отдельного этапа копирования уже готового архива с локального диска на S3 здесь нет: после подготовки временного снимка данные сжимаются и сразу отправляются в целевое хранилище.
Настройка
Ставим rclone:
# curl https://rclone.org/install.sh | bashПрописываем remote в ~/.config/rclone/rclone.conf:
[s3test]
type = s3
provider = Other
env_auth = false
access_key_id = ВАШ_КЛЮЧ
secret_access_key = ВАШ_СЕКРЕТ
endpoint = https://s3b.geekrack.ru
Дальше нужен systemd-юнит, который оживит FUSE-монтирование
# /etc/systemd/system/rclone-synology-backup.service
[Unit]
Description=rclone mount s3test (dump bucket) - backs the Proxmox storage synology-backup
After=network-online.target
Wants=network-online.target

[Service]
Type=notify
ExecStart=/usr/bin/rclone mount s3test:dump /mnt/pve/synology-backup-s3 \
--allow-other \
--vfs-cache-mode writes \
--vfs-cache-max-size 80G \
--cache-dir /var/cache/rclone \
--dir-cache-time 30s \
--umask 000 \
--transfers 1 \
--s3-upload-concurrency 2 \
--s3-chunk-size 64M

ExecStop=/bin/fusermount -uz /mnt/pve/synology-backup-s3
Restart=on-failure
RestartSec=5

[Install]
WantedBy=multi-user.target
Последние три флага (--transfers, --s3-upload-concurrency, --s3-chunk-size) я поставил не сразу - до них пришлось дойти методом проб и ошибок, расскажу дальше.
И регистрируем storage в Proxmox:
# pvesm add dir synology-backup --path /mnt/pve/synology-backup-s3 --content backupЗдесь стоит отдельно пояснить название хранилища. Раньше в Proxmox у меня уже было хранилище с именем synology-backup, который указывал на NFS-шару той же Synology, смонтированную в /mnt/pve/synology-backup — без суффикса -s3.
При переходе на S3 я решил не создавать новый storage под другим именем, а сохранить существующий synology-backup, изменив только путь, на который он указывает: теперь это /mnt/pve/synology-backup-s3.
Причина довольно простая: все существующие задания vzdump, а также конфигурация в Terraform уже ссылались на storage по имени synology-backup. Переписывать всю связанную конфигурацию ради смены бэкенда особого смысла не было — гораздо проще оставить прежнее имя и заменить только физическое расположение хранилища. Поэтому дальше по тексту не стоит удивляться, если synology-backup фактически окажется S3-хранилищем. Это не опечатка, а намеренное решение, позволяющее сохранить совместимость с уже существующей конфигурацией. При этом старая NFS-шара никуда не исчезла и по-прежнему смонтирована отдельно в /mnt/pve/synology-backup — без -s3. Просто Proxmox больше не использует её в качестве целевого хранилища для резервных копий.
В итоге цепочка от storage в Proxmox до физического хранилища выглядит следующим образом:
Proxmox storage "synology-backup" → /mnt/pve/synology-backup-s3 (точка монтирования) → rclone FUSE, remote "s3test:dump" → S3 API → Gerbil → туннель до сайта "NAS" → RustFS на SynologyДальше всё просто: любая задача резервного копирования (vzdump) с хранилища synology-backup пишет прямо в S3-бакет, ничего в самих job'ах или в Terraform (ранее я рассказывал как строю лабу с OpenTofu) менять не пришлось.
Тест 1. Проверка скорости копирования
Прежде чем приступить к монтированию, решил сначала проверить, а какая вообще скорость копирования с каналом в 1 Гбит:
# time curl -X PUT -T testfile "https://s3***.geekrack.ru/dump/testfile" -H "Authorization: ..."В итоге получилось около 5,04 МБ/с. Для сравнения: пинг до самого Gerbil — публичной точки входа Pangolin - составляет примерно 1 мс, тогда как до ресурсов за сайтом NAS, то есть непосредственно до NAS через внутренний туннель, — уже около 90 мс.
Такая разница вполне объяснима: Gerbil находится рядом с сервером, но дальше трафику необходимо пройти ещё через отдельный туннель до NAS, расположенного у меня дома. Из этого можно сделать довольно простой вывод: «сырая» скорость работы с S3 практически не отличается от того, что раньше получалось через NFS, — всё те же 5–9 МБ/с. Сама по себе смена протокола никакого заметного прироста не дала.
Основным ограничением здесь оказался не NFS или S3, а общий туннель Pangolin, через который одновременно проходит трафик всех сайтов. Именно он в данном случае остаётся главным узким местом.
Тест 2. Проверка скорости копирования в реальных условиях выполнения РК
Первый полноценный запуск vzdump через новое хранилище дал довольно неожиданный результат. Архив размером около 270 МБ, судя по логам Proxmox, был создан всего за 10 секунд. Эта цифра сразу показалась подозрительной: при измеренной ранее скорости около 5 МБ/с передача такого объёма должна занимать как минимум около минуты.
Чтобы проверить, действительно ли архив уже оказался на S3, я посмотрел содержимое бакета напрямую через rclone lsl <remote>:. Эта команда показывает объекты на удалённом бэкенде, не полагаясь на локальный VFS-кэш. И ожидаемо выяснилось, что сразу после завершения vzdump архива на удалённой стороне ещё не было.
Причина оказалась в использовании --vfs-cache-mode writes. В такой конфигурации vzdump записывает архив в смонтированную директорию, а rclone сначала принимает его в локальный кэш. Для Proxmox на этом операция записи уже считается завершённой, поэтому в логе появляется Finished, хотя rclone в этот момент ещё может продолжать отправлять данные на S3 в фоне.
В моём случае фактическая загрузка архива на удалённое хранилище завершалась ещё примерно через 38–70 секунд после того, как Proxmox уже сообщил об успешном окончании задания. Поэтому время выполнения vzdump при такой схеме нельзя использовать для оценки реальной скорости S3-бэкенда: фактически оно показывает, насколько быстро архив был записан в локальный кэш rclone. Если нужно понять, когда резервная копия действительно оказалась на удалённой стороне, проверять это следует непосредственно на remote.
Ошибка 1: Нехватка памяти
Первая же полноценная проверка новой схемы в боевых условиях выявила проблему. Во время ночного запуска резервного копирования, когда vzdump последовательно обрабатывал 13 контейнеров, задания начали падать с ошибкой:
zstd: error 70 : Write error : cannot write block : Input/output errorERROR : IO error: write /tmp/rclone/vfs/.../*.tar.dat: no space left on device
Причина оказалась довольно банальной. По умолчанию rclone размещает VFS-кэш в /tmp, а на этом сервере /tmp смонтирован как tmpfs. Иными словами, кэш фактически находился не на диске, а в оперативной памяти.
При параллельной записи нескольких архивов объём кэша быстро рос и в какой-то момент начинал упираться в доступную RAM. Своп, которого на сервере было всего 4 ГБ, также оказался практически полностью занят: free -h показывал около 15 ГБ используемой памяти и почти полностью заполненный swap. В результате очередная запись в кэш завершалась ошибкой, а вместе с ней падало и задание резервного копирования.
Решение оказалось простым: вынести кэш rclone из tmpfs на обычный диск и заодно ограничить его максимальный размер, чтобы при длительной или параллельной записи он не мог расти бесконтрольно:
ExecStart=/usr/bin/rclone mount s3test:dump /mnt/pve/synology-backup-s3 --vfs-cache-mode writes --vfs-cache-max-size 80G --cache-dir /var/cache/rclone --dir-cache-time 30s --umask 000После внесённых изменений я повторно запустил всю ночную серию резервного копирования. На этот раз все 13 контейнеров, включая самый крупный с диском объёмом 120 ГБ, успешно прошли бэкап без единой ошибки.
Ошибка 2: Бесконечный цикл повторной загрузки
Параллельно я занимался другой задачей и не учёл, что перезапуск контейнеров с Gerbil и Traefik может оборвать уже выполняющуюся передачу данных. В результате соединение периодически разрывалось, а rclone снова и снова запускал загрузку незавершённых файлов. Масштаб проблемы стал заметен по трафику: передать требовалось примерно 127 ГБ, однако фактически через сокет прошло около 247 ГБ — почти вдвое больше.
Чтобы понять, откуда взялся такой перерасход, я отдельно разобрал логи загрузки одного файла размером около 21 ГБ. За семь часов rclone предпринял 12 попыток его загрузить, причём номер части, на которой происходил очередной сбой, постоянно менялся: то продвигался вперёд, то снова возвращался к началу.
Если бы после обрыва rclone продолжал ту же multipart-загрузку с недостающей части, номер загружаемого куска постепенно увеличивался бы. Но по логам было видно обратное: после очередного сбоя загрузка периодически снова начиналась с первых частей. Это указывало на создание новой multipart-сессии с новым upload-id, тогда как уже переданные части предыдущей попытки оставались на S3-бэкенде как незавершённая multipart-загрузка.
Получался неприятный замкнутый круг: соединение обрывается → загрузка начинается заново → уже переданные данные приходится отправлять повторно → растут трафик и нагрузка → вероятность очередного сбоя увеличивается ещё сильнее.
Поэтому увеличивать количество повторных попыток здесь было бы скорее контрпродуктивно. Вместо этого я решил снизить параллелизм и количество одновременно выполняемых запросов для одного файла:
- ExecStart=/usr/bin/rclone mount s3test:dump /mnt/pve/synology-backup-s3 \
-   --vfs-cache-mode writes --dir-cache-time 30s --umask 000
+ ExecStart=/usr/bin/rclone mount s3test:dump /mnt/pve/synology-backup-s3 \
+   --vfs-cache-mode writes --vfs-cache-max-size 80G \
+   --cache-dir /var/cache/rclone --dir-cache-time 30s --umask 000
--transfers 1- грузим файлы по одному, а не по четыре одновременно--s3-upload-concurrency 2- меньше параллельных кусков на один файл--s3-chunk-size 64Mвместо стандартных 5 МБ - на 21-гигабайтный файл это примерно 330 запросов вместо 4200, а значит куда меньше шансов упасть где-то посередине
После изменения настроек я повторил загрузку семи недокачанных архивов общим объёмом около 58 ГБ. На этот раз все они успешно ушли на S3 один за другим, без единой ошибки или повторного запуска. Но в процессе обнаружился ещё один любопытный момент. Чтобы оценить уже не скорость записи в локальный кэш, а фактическую скорость передачи данных по сети, я посмотрел статистику TCP-сокета через ss -tin, ориентируясь на значения bytes_sent и busy:
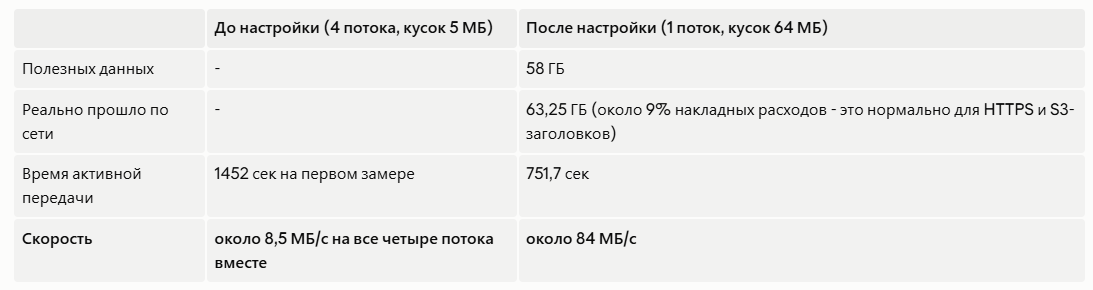
Разница получилась не просто заметной, а почти на порядок. Рабочая гипотеза следующая: при четырёх параллельных потоках они фактически начинали конкурировать за один и тот же туннель Pangolin. В результате суммарная скорость оставалась примерно на уровне тех же 8–9 МБ/с, которые раньше показывал NFS. Когда же поток оставался один, весь туннель оказывался в его распоряжении, и скорость передачи возрастала примерно в десять раз. Если эта гипотеза верна, то узким местом является не столько пропускная способность самого канала, сколько поведение userspace-туннеля Pangolin при нескольких одновременных соединениях. Возможно, свою роль здесь играют особенности туннелирования и сравнительно небольшой MTU — в моём случае 1280.
Однако здесь важно сделать оговорку. Успешный прогон с одним потоком длился около 47 минут, тогда как проблемы при четырёх параллельных потоках начинали проявляться только спустя несколько часов непрерывной нагрузки. Поэтому однозначно утверждать, что причина именно в количестве потоков, пока нельзя. Не исключён и другой вариант: например, RustFS или какой-то другой компонент цепочки начинает нестабильно работать именно при продолжительной нагрузке независимо от уровня параллелизма. Чтобы окончательно проверить эту гипотезу, нужен ещё один длительный тест с одним потоком — сопоставимый по времени с тем прогоном, на котором возникали сбои.
Поэтому на данном этапе вывод скорее промежуточный: снижение параллелизма одновременно устранило ошибки и дало почти десятикратный прирост фактической скорости передачи, но причинно-следственная связь между этими двумя эффектами пока не доказана окончательно. Цифры хорошо укладываются в гипотезу о конкуренции потоков внутри туннеля, однако для уверенного вывода нужен более продолжительный контрольный тест.
Что в итоге
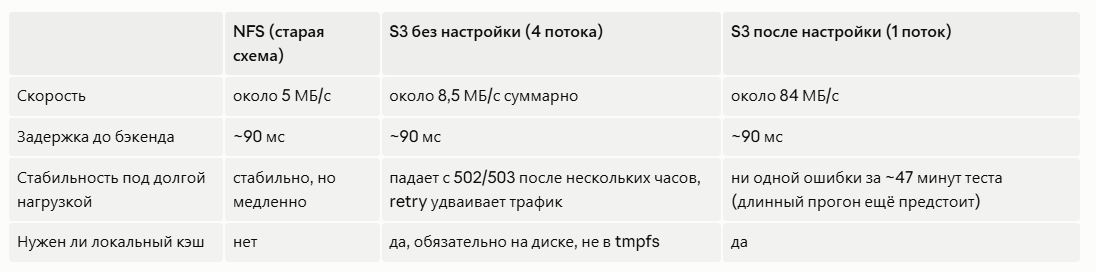
Если подвести итог, сама по себе замена NFS на S3 никакого прироста скорости не дала. Первоначальное узкое место оказалось не в протоколе хранения, а в сети. Причём заметный прирост удалось получить совсем не там, где я его ожидал: не за счёт увеличения количества параллельных потоков, а, наоборот, за счёт их сокращения.
В моей конфигурации переход от нескольких параллельных загрузок к одной одновременно решил проблему со сбоями и увеличил фактическую скорость передачи примерно с 8,5 до 84 МБ/с. Почему именно так ведёт себя связка Pangolin + RustFS, ещё предстоит проверить длительным тестом, но как минимум результат показал, что принцип «больше потоков — выше скорость» для подобных туннелей работает далеко не всегда.
Если будете повторять у себя
Прежде чем настраивать FUSE,
rcloneи интеграцию с Proxmox, проверьте чистую скорость канала обычнымcurl. Такой простой тест может сэкономить несколько часов поиска проблемы совсем не в том месте.Обязательно вынесите кэш
rclone(--cache-dir) на настоящий диск. Не стоит полагаться на/tmp: сначала проверьте, чем он является в вашей системе, например черезmount | grep /tmp. Если этоtmpfs, кэш будет занимать оперативную память.Задайте
--vfs-cache-max-sizeс запасом относительно размера самого крупного резервного архива, который может оказаться в кэше.Не ориентируйтесь только на время завершения
vzdump. При--vfs-cache-mode writesзадача может получить статусFinished, когда архив ещё находится в локальном кэше и продолжает загружаться на S3. Фактическое наличие объекта лучше проверять непосредственно на удалённой стороне черезrclone lsl <remote>:.Если под длительной нагрузкой начинаются ошибки, не спешите увеличивать количество повторных попыток. Сначала попробуйте снизить
--transfersи--s3-upload-concurrency, а также увеличить размер загружаемой части.Обязательно сравните скорость с несколькими параллельными потоками и с одним. На туннелях вроде Pangolin разница может измеряться не процентами, а разами. В моём случае получилось примерно 8,5 МБ/с против 84 МБ/с.
Если используемый S3-бэкенд находится в beta/dev-стадии или просто не рассчитан на production-нагрузку, не делайте выводы по одному успешно загруженному файлу. Гораздо показательнее несколько часов непрерывной передачи данных.
На этом эксперимент пока не закончен. Впереди ещё длительный прогон с одним потоком — сопоставимый по продолжительности с тестом, во время которого возникали сбои. Он должен показать, действительно ли ключевым фактором оказался параллелизм или проблема проявляется просто после нескольких часов непрерывной нагрузки. Когда появятся результаты, дополню ими статью или вынесу их в отдельный материал.
Если у вас есть похожая схема с Pangolin, NFS или S3 поверх домашнего NAS - поделитесь результатами в комментариях. Особенно интересно сравнить поведение с другими вариантами туннелирования, например Tailscale или обычным WireGuard: сохраняется ли там такая же зависимость скорости от параллелизма или это особенность именно моей конфигурации.
И если этот разбор сэкономил вам несколько часов на диагностике и экспериментах - буду рад, если Вы поделитесь статьёй с теми, кто настраивает похожую инфраструктуру.
Опыт применения 0
Попробовали решение в своей задаче? Расскажите, что получилось.
Станьте первым, кто прокомментирует эту запись
Комментировать